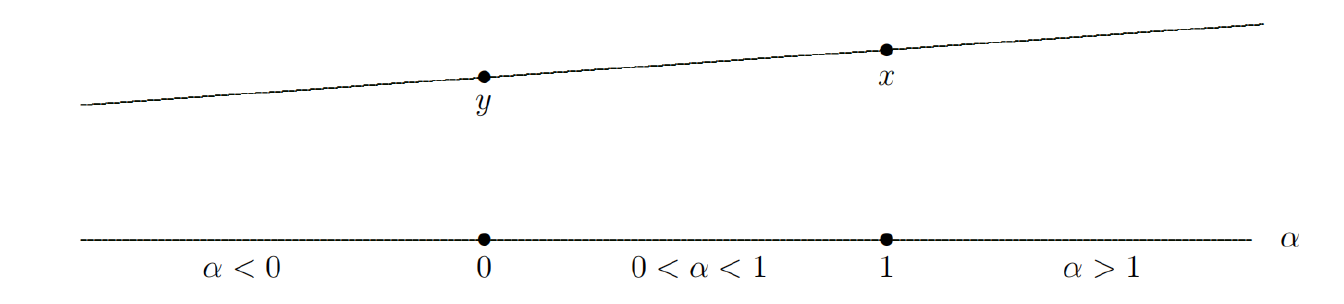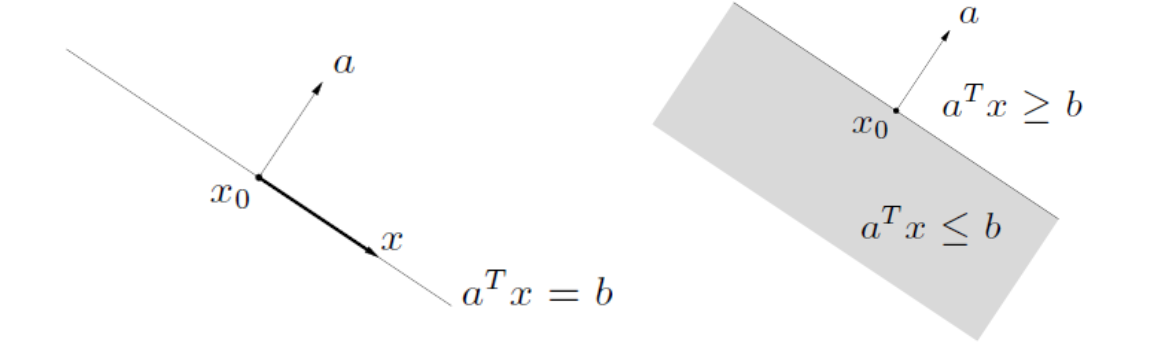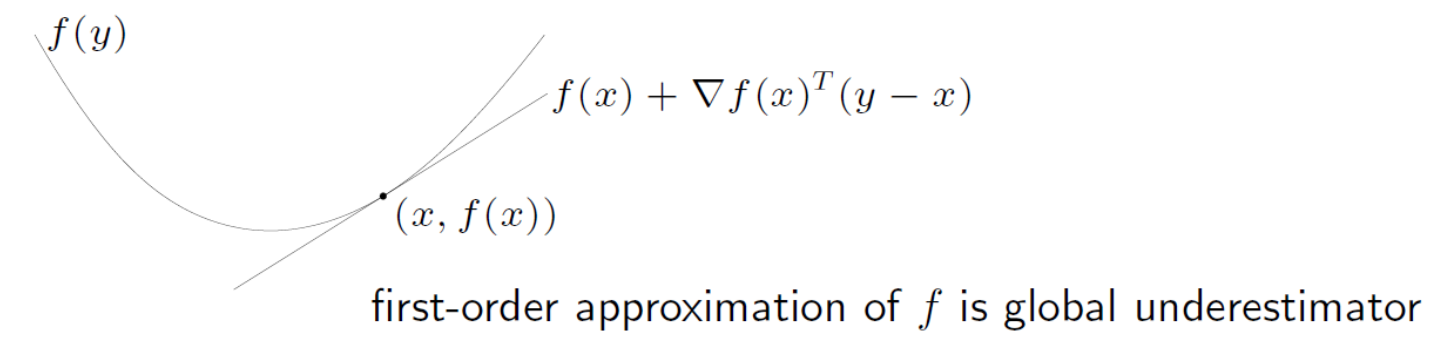最优化理论与方法-引言和预备知识

引言和预备知识

引言

  • Optimization
    • 所谓最优化或优化问题通常泛指各类定量决策问题,即如
      何在各种限制约束之下,寻找解决问题的最佳可⾏⽅案,
      使得⼀项或者多项衡量指标达到某种意义上的最优
      。
    • 这种⼒求达到最优或遵循最优的原则可以说是⼀种⾮常⾃
      然和普遍存在的决策⽬标。通常,我们不仅想找到解决问
      题的可⾏⽅案,还总是希望找到⼀个最好的可⾏⽅案。
    • 甚⾄,这也是宇宙万物的⼀种变化规律。
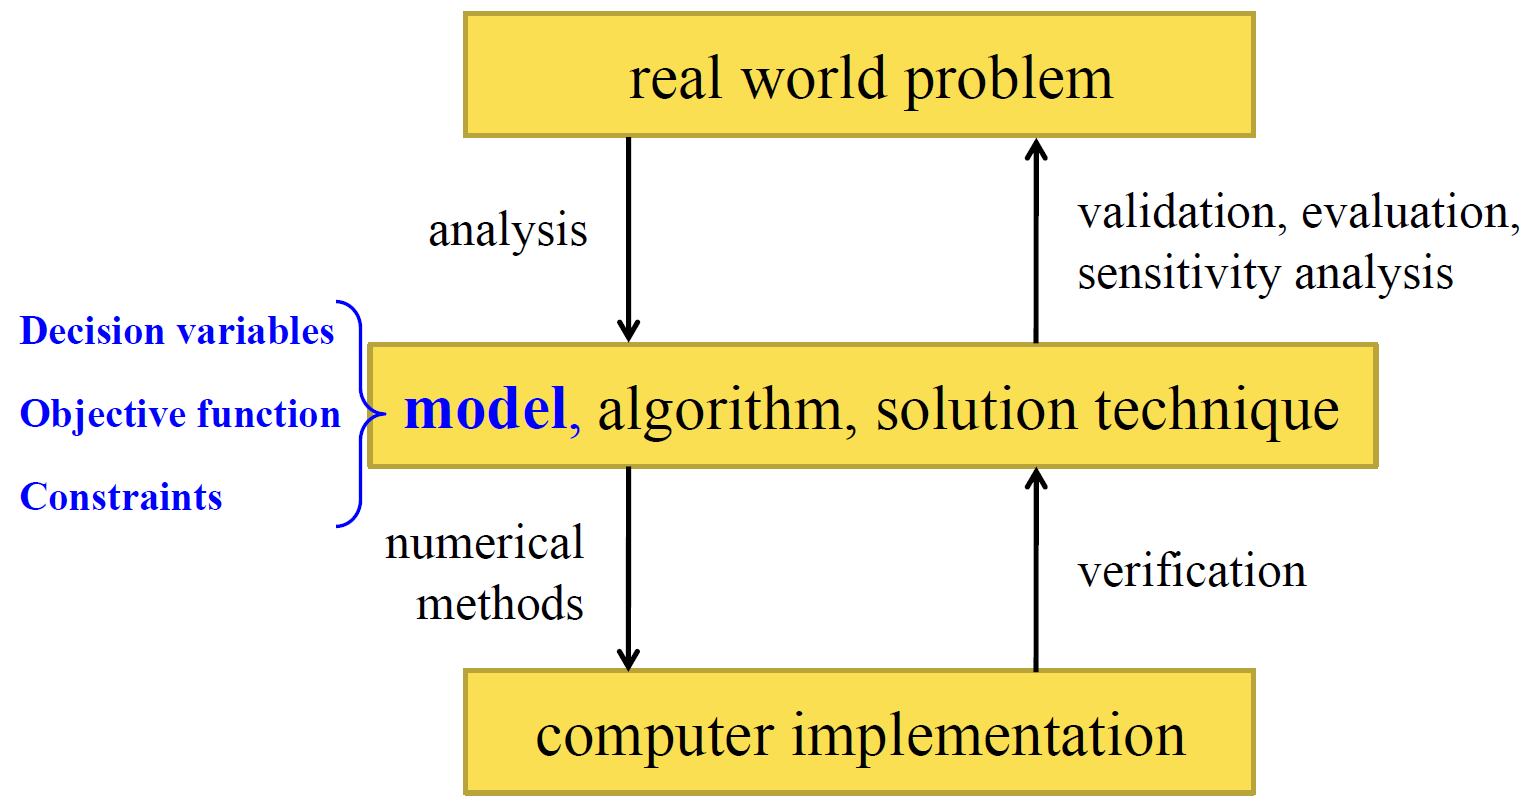
  • 优化的过程

    优化的过程

  • 数学规划的一般形式:

    min⁡(max⁡)  f(x)s.t. hi(x)=0,i=1,⋯ ,mgj(x)≤0,j=1,⋯ ,r\begin{aligned} &\min (\max) \; f(\mathbf{x}) \\ \text{s.t. } &h_i(\mathbf{x}) = 0, i = 1, \cdots, m \\ & g_j(\mathbf{x}) \leq 0, j = 1, \cdots, r \end{aligned}

    其中:

    • x=(x1,…,xn)T\mathbf{x} = (x_1, \ldots, x_n)^T:决策变量
    • f:Rn→Rf: \mathbb{R}^n \to \mathbb{R}:目标函数
    • hi,gj:Rn→R,i=1,…,m,j=1,…,rh_i, g_j: \mathbb{R}^n \to \mathbb{R}, i = 1, \ldots, m, j = 1, \ldots, r:约束函数
    • Ω={x∈Rn|hi(x)=0,i=1,⋯ ,m;gj(x)≤0,j=1,⋯ ,r}\Omega = \left\{ \mathbf{x} \in \mathbb{R}^n \middle| h_i(\mathbf{x}) = 0, i = 1, \cdots, m; g_j(\mathbf{x}) \leq 0, j = 1, \cdots, r \right\}:可行域
  • 数学规划(Mathematical Programming)的分类

    • 线性 / 非线性 (如:二次规划、凸规划)
    • 光滑 / 非光滑
    • 凸 / 非凸
    • 连续 / 离散 (如:整数规划、混合整数规划)
    • 静态 / 动态 (如:动态规划)
    • 确定性 / 随机性 (如:随机规划、鲁棒优化)
    • 有约束 / 无约束

预备知识

线性代数基础知识

  • 向量和矩阵

    • 向量通常用小写字母表示,矩阵通常用大写字母表示。
    • 长度为 nn 的实向量空间记为 Rn\mathbb{R}^n。
    • m×nm \times n 阶实矩阵空间记为 Rm×n\mathbb{R}^{m \times n}。
    • 若矩阵 A∈Rn×nA \in \mathbb{R}^{n \times n} 满足 A=ATA = A^T,则称 AA 为对称矩阵。
    • 对称矩阵 AA 称为正定(记作 A≻0A \succ 0),如果
      xTAx>0,∀ x≠0, x∈Rn x^T A x > 0, \quad \forall\, x \neq 0,\ x \in \mathbb{R}^n
    • 若对任意 x∈Rnx \in \mathbb{R}^n,有
      xTAx≥0, x^T A x \geq 0,

      则称 AA 为半正定(记作 A⪰0A \succeq 0)。
  • 范数

    • 一般来说,一个范数 ∥⋅∥\|\cdot\| 是一个实值函数,满足以下性质:

      • 非负性:对所有 xx,有 ∥x∥≥0\|x\| \geq 0;
      • 正定性:∥x∥=0\|x\| = 0 当且仅当 x=0x = 0;
      • 齐次性:对任意实数 α\alpha,有 ∥αx∥=∣α∣ ∥x∥\|\alpha x\| = |\alpha| \, \|x\|;
      • 三角不等式:对所有 x,yx, y,有 ∥x+y∥≤∥x∥+∥y∥\|x + y\| \leq \|x\| + \|y\|。
    • 对于矩阵范数,以下性质有用但非必需:

      • 相容性(次可乘性):对任意可乘的矩阵 XX 和 YY,有
        ∥XY∥≤∥X∥ ∥Y∥. \|XY\| \leq \|X\| \, \|Y\|.
  • 向量范数

    • l1l_1 范数:
      ∥x∥1=∑i=1n∣xi∣\|x\|_1 = \sum_{i=1}^{n} |x_i|

    • 欧几里得范数(l2l_2 范数):
      ∥x∥2=xTx=∑i=1nxi2\|x\|_2 = \sqrt{x^T x} = \sqrt{\sum_{i=1}^{n} x_i^2}

    • l∞l_\infty 范数:
      ∥x∥∞=max⁡1≤i≤n∣xi∣\|x\|_\infty = \max_{1 \leq i \leq n} |x_i|

    • lpl_p 范数(p≥1p \geq 1):
      ∥x∥p=(∑i=1n∣xi∣p)1p\|x\|_p = \left( \sum_{i=1}^{n} |x_i|^p \right)^{\frac{1}{p}}

    • 加权范数(由正定矩阵诱导):
      ∥x∥G=xTGx\|x\|_G = \sqrt{x^T G x},其中 GG 为对称正定矩阵(即 G≻0G \succ 0)

    • l0l_0 “范数”:
      ∥x∥0=\|x\|_0 = 向量中非零元素的个数。

      严格来说,l0l_0 并不满足范数的齐次性,因此不是真正的范数。

  • 向量范数的性质

    • 内积定义:
      向量 xx 与 yy 的内积记为

      x⋅y≡xTy=∑i=1nxiyi x \cdot y \equiv x^T y = \sum_{i=1}^n x_i y_i

    • Hölder 不等式:
      对任意 p,q≥1p, q \geq 1 满足 1p+1q=1\frac{1}{p} + \frac{1}{q} = 1,有

      ∣xTy∣≤∥x∥p ∥y∥q |x^T y| \leq \|x\|_p \, \|y\|_q

    • 对偶范数表示:
      lpl_p 范数可通过对偶形式表示为

      ∥x∥p=max⁡∥y∥q≤1xTy,其中 1p+1q=1 \|x\|_p = \max_{\|y\|_q \leq 1} x^T y, \quad \text{其中 } \frac{1}{p} + \frac{1}{q} = 1

    • 特例 1:p=q=2p = q = 2(Cauchy–Schwarz 不等式)

      ∣xTy∣≤∥x∥2 ∥y∥2,∥x∥2=max⁡∥y∥2≤1xTy |x^T y| \leq \|x\|_2 \, \|y\|_2, \quad \|x\|_2 = \max_{\|y\|_2 \leq 1} x^T y

    • 特例 2:p=1p = 1, q=∞q = \infty

      ∣xTy∣≤∥x∥1 ∥y∥∞ |x^T y| \leq \|x\|_1 \, \|y\|_\infty

      且
      ∥x∥1=max⁡∥y∥∞≤1xTy,∥x∥∞=max⁡∥y∥1≤1xTy \|x\|_1 = \max_{\|y\|_\infty \leq 1} x^T y, \quad \|x\|_\infty = \max_{\|y\|_1 \leq 1} x^T y

    • 欧几里得范数与内积的关系:

      ∥x∥22+∥y∥22=∥x+y∥22−2xTy=∥x−y∥22+2xTy=12(∥x+y∥22+∥x−y∥22)≥2 ∣xTy∣ \begin{aligned} \|x\|_2^2 + \|y\|_2^2 &= \|x + y\|_2^2 - 2x^T y \\ &= \|x - y\|_2^2 + 2x^T y \\ &= \frac{1}{2} \left( \|x + y\|_2^2 + \|x - y\|_2^2 \right) \\ &\geq 2\,|x^T y| \end{aligned}

    • 向量范数的等价性:
      在 Rn\mathbb{R}^n 中,任意两种向量范数 ∥⋅∥∗\|\cdot\|_* 与 ∥⋅∥+\|\cdot\|_+ 均满足

      c1∥x∥+≤∥x∥∗≤c2∥x∥+,其中 c1,c2>0 为常数 c_1 \|x\|_+ \leq \|x\|_* \leq c_2 \|x\|_+, \quad \text{其中 } c_1, c_2 > 0 \text{ 为常数}

      特别地,常见范数之间有如下具体关系:
      ∥x∥2≤∥x∥1≤n ∥x∥2∥x∥∞≤∥x∥2≤n ∥x∥∞∥x∥∞≤∥x∥1≤n ∥x∥∞ \begin{aligned} &\|x\|_2 \leq \|x\|_1 \leq \sqrt{n}\, \|x\|_2 \\ &\|x\|_\infty \leq \|x\|_2 \leq \sqrt{n}\, \|x\|_\infty \\ &\|x\|_\infty \leq \|x\|_1 \leq n\, \|x\|_\infty \end{aligned}

  • 矩阵范数

    • 最常用的矩阵范数是由向量范数诱导的范数(也称为算子范数或诱导范数),定义为:

      ∥A∥p=max⁡x≠0∥Ax∥p∥x∥p \|A\|_p = \max_{x \neq 0} \frac{\|A x\|_p}{\|x\|_p}

    • 1-范数(列和范数):

      ∥A∥1=max⁡1≤j≤n∑i=1m∣aij∣ \|A\|_1 = \max_{1 \leq j \leq n} \sum_{i=1}^{m} |a_{ij}|

      即所有列向量绝对值之和的最大值。

    • 2-范数(谱范数):

      ∥A∥2=λmax⁡(ATA) \|A\|_2 = \sqrt{\lambda_{\max}(A^T A)}

      其中 λmax⁡(ATA)\lambda_{\max}(A^T A) 是 ATAA^T A 的最大特征值。

    • ∞\infty-范数(行和范数):

      ∥A∥∞=max⁡1≤i≤m∑j=1n∣aij∣ \|A\|_\infty = \max_{1 \leq i \leq m} \sum_{j=1}^{n} |a_{ij}|

      即所有行向量绝对值之和的最大值。

    • Frobenius 范数(弗罗贝尼乌斯范数):

      ∥A∥F=tr⁡(ATA)=∑i=1m∑j=1naij2 \|A\|_F = \sqrt{\operatorname{tr}(A^T A)} = \sqrt{\sum_{i=1}^{m} \sum_{j=1}^{n} a_{ij}^2}

    • 迹(Trace)的性质:

      tr⁡(ATB)=∑j=1n∑i=1maijbij \operatorname{tr}(A^T B) = \sum_{j=1}^{n} \sum_{i=1}^{m} a_{ij} b_{ij}

      即两个矩阵对应元素乘积之和(等价于向量化后的内积)。

    • Frobenius 范数的展开公式:

      ∥A+B∥F2=∥A∥F2+∥B∥F2+2 tr⁡(ATB) \|A + B\|_F^2 = \|A\|_F^2 + \|B\|_F^2 + 2\,\operatorname{tr}(A^T B)

    • 正交矩阵(Orthogonal Matrix)的性质:
      若 QQ 为正交矩阵,则满足:

      QQT=QTQ=I(因此 QT=Q−1) Q Q^T = Q^T Q = I \quad \text{(因此 } Q^T = Q^{-1} \text{)}

      并且保持以下范数不变:
      ∥QA∥F=∥A∥F,∥QA∥2=∥A∥2,∥Qx∥2=∥x∥2 \|Q A\|_F = \|A\|_F, \quad \|Q A\|_2 = \|A\|_2, \quad \|Q x\|_2 = \|x\|_2

  • Sherman-Morrison公式

    • 假设原始矩阵 A∈Rn×nA \in \mathbb{R}^{n \times n},且扰动后的矩阵为 B=A+uvTB = A + uv^T,其中 u,v∈Rnu, v \in \mathbb{R}^n。

    • 如果已知 A−1A^{-1},如何高效地计算扰动矩阵 BB 的逆矩阵?

    • 步骤 1:求解 (I+uvT)−1(I + uv^T)^{-1}

      首先,假设矩阵 (I+uvT)(I + uv^T) 的逆矩阵形式为 (I+ρuvT)(I + \rho uv^T),则 ρ\rho 的值为:

      (I+uvT)(I+ρuvT)=I+[1+ρ(1+vTu)]uvT (I + uv^T)(I + \rho uv^T) = I + [1 + \rho(1 + v^T u)]uv^T

      由此得出:
      ρ=−11+vTu \rho = -\frac{1}{1 + v^T u}

      因此:
      (I+uvT)−1=I−uvT1+vTu (I + uv^T)^{-1} = I - \frac{uv^T}{1 + v^T u}

    • 步骤 2:利用上述关系计算 (A+uvT)−1(A + uv^T)^{-1}

      其次,利用上述关系,我们有:

      (A+uvT)−1=(A(I+A−1uvT))−1=(I+A−1uvT)−1A−1=(I−A−1uvT1+vTA−1u)A−1=A−1−A−1uvTA−11+vTA−1u \begin{aligned} (A + uv^T)^{-1} &= \left(A(I + A^{-1}uv^T)\right)^{-1} \\ &= (I + A^{-1}uv^T)^{-1}A^{-1} \\ &= \left(I - \frac{A^{-1}uv^T}{1 + v^T A^{-1} u}\right)A^{-1} \\ &= A^{-1} - \frac{A^{-1}uv^TA^{-1}}{1 + v^T A^{-1} u} \end{aligned}

      其中要求 1+vTA−1u≠01 + v^T A^{-1} u \neq 0。

    • 通过以上步骤,我们可以高效地计算出扰动矩阵 B=A+uvTB = A + uv^T 的逆矩阵,而不需要重新进行完整的矩阵求逆运算。这种方法在处理大型矩阵时特别有用,因为它避免了高计算复杂度的直接求逆过程。

  • oo, OO 记号

    • 设 gg 是一个实变量的实值函数。

    • 记号 g(x)=O(x)g(x) = O(x) 表示当 x→0x \to 0 时,g(x)g(x) 趋于零的速度至少与 xx 一样快。
      更精确地,存在常数 K>0K > 0,使得

      ∣g(x)x∣≤K当 x→0. \left| \frac{g(x)}{x} \right| \leq K \quad \text{当 } x \to 0.

    • 记号 g(x)=o(x)g(x) = o(x) 表示 g(x)g(x) 趋于零的速度比 xx 更快,即

      lim⁡x→0g(x)x=0. \lim_{x \to 0} \frac{g(x)}{x} = 0.

    • 在算法分析中,大 OO 符号通常用于描述渐近上界(当 n→∞n \to \infty):

      g(n)=O(f(n))若存在 C>0 使得 g(n)≤Cf(n) 对足够大的 n 成立. g(n) = O(f(n)) \quad \text{若存在 } C > 0 \text{ 使得 } g(n) \leq C f(n) \text{ 对足够大的 } n \text{ 成立}.

      • 例如:3n3+2n2+5=O(n3)3n^3 + 2n^2 + 5 = O(n^3)。若算法复杂度为 O(n3)O(n^3),则输入规模 nn 翻倍时,运行时间约增至 8 倍(对大 nn 而言)。
    • 在数值分析或泰勒展开中,大 OO 和小 oo 常用于描述逼近误差(当 h→0h \to 0):

      g(h)=O(f(h))若 ∣g(h)∣≤C∣f(h)∣ 当 h→0, g(h) = O(f(h)) \quad \text{若 } |g(h)| \leq C |f(h)| \text{ 当 } h \to 0,

      g(h)=o(f(h))若 lim⁡h→0g(h)f(h)=0. g(h) = o(f(h)) \quad \text{若 } \lim_{h \to 0} \frac{g(h)}{f(h)} = 0.

    • 例如,当 ∣h∣<1|h| < 1 时:

      11−h=1+h+h2+h3+⋯=1+h+O(h2), \frac{1}{1 - h} = 1 + h + h^2 + h^3 + \cdots = 1 + h + O(h^2),

      且更精细地,
      11−h=1+h+h2+o(h2). \frac{1}{1 - h} = 1 + h + h^2 + o(h^2).

多元函数分析

  • 梯度和Hessian矩阵

    • 设 ff 是一个 nn 元实值函数:

      f(x)=f(x1,x2,…,xn) f(x) = f(x_1, x_2, \dots, x_n)

    • 函数 ff 的一阶偏导数组成的向量称为梯度(gradient),记作 ∇f(x)\nabla f(x):

      ∇f(x)=(∂f(x)∂x1,∂f(x)∂x2,…,∂f(x)∂xn)T \nabla f(x) = \left( \frac{\partial f(x)}{\partial x_1}, \frac{\partial f(x)}{\partial x_2}, \dots, \frac{\partial f(x)}{\partial x_n} \right)^T

    • 函数 ff 的二阶偏导数组成的矩阵称为Hessian 矩阵(或简称 Hessian),记作 ∇2f(x)\nabla^2 f(x),其 (i,j)(i,j) 元素定义为:

      [∇2f(x)]ij=∂2f(x)∂xi∂xj [\nabla^2 f(x)]_{ij} = \frac{\partial^2 f(x)}{\partial x_i \partial x_j}

    • 若 ff 的二阶偏导数连续,则 Hessian 矩阵是对称的,即:

      ∂2f(x)∂xi∂xj=∂2f(x)∂xj∂xi \frac{\partial^2 f(x)}{\partial x_i \partial x_j} = \frac{\partial^2 f(x)}{\partial x_j \partial x_i}

    • 练习:计算以下函数的梯度与 Hessian 矩阵:

      f(x1,x2)=2x14+3x12x2+2x1x23+4x22 f(x_1, x_2) = 2x_1^4 + 3x_1^2 x_2 + 2x_1 x_2^3 + 4x_2^2

      解:
      ∇f(x)=(8x13+6x1x2+2x233x12+6x1x22+8x2),∇2f(x)=(24x12+6x26x1+6x226x1+6x2212x1x2+8) \nabla f(x) = \begin{pmatrix} 8x_1^3 + 6x_1 x_2 + 2x_2^3 \\ 3x_1^2 + 6x_1 x_2^2 + 8x_2 \end{pmatrix}, \quad \nabla^2 f(x) = \begin{pmatrix} 24x_1^2 + 6x_2 & 6x_1 + 6x_2^2 \\ 6x_1 + 6x_2^2 & 12x_1 x_2 + 8 \end{pmatrix}

    • 练习:计算以下函数的梯度与 Hessian 矩阵:

      f(x)=12xTQx−bTx,其中 Q∈Rn×n 为对称矩阵 f(x) = \frac{1}{2} x^T Q x - b^T x, \quad \text{其中 } Q \in \mathbb{R}^{n \times n} \text{ 为对称矩阵}

      解:
      ∇f(x)=Qx−b,∇2f(x)=Q \nabla f(x) = Qx - b, \quad \nabla^2 f(x) = Q

  • 雅可比矩阵

    • 考虑向量值函数 f:Rn→Rmf: \mathbb{R}^n \to \mathbb{R}^m:

      f(x)=(f1(x)f2(x)⋮fm(x)) f(x) = \begin{pmatrix} f_1(x) \\ f_2(x) \\ \vdots \\ f_m(x) \end{pmatrix}

    • 其 Jacobian 矩阵 是一个 m×nm \times n 矩阵,第 ii 行第 jj 列元素为 ∂fi/∂xj\partial f_i / \partial x_j,即:

      Jf(x)=[∂fi∂xj] J_f(x) = \left[ \frac{\partial f_i}{\partial x_j} \right]

    • 练习:计算

      f(x)=(sin⁡x1+cos⁡x2e3x1+x224x13+7x1x22) f(x) = \begin{pmatrix} \sin x_1 + \cos x_2 \\ e^{3x_1 + x_2^2} \\ 4x_1^3 + 7x_1 x_2^2 \end{pmatrix}

      的 Jacobian。

    • Jacobian 为:

      (cos⁡x1−sin⁡x23e3x1+x222x2e3x1+x2212x12+7x2214x1x2) \begin{pmatrix} \cos x_1 & -\sin x_2 \\ 3e^{3x_1 + x_2^2} & 2x_2 e^{3x_1 + x_2^2} \\ 12x_1^2 + 7x_2^2 & 14x_1 x_2 \end{pmatrix}

  • 链式法则

    • 求复合函数导数的法则称为链式法则(chain rule)。

    • 考虑函数 g(x)=g(x1,…,xn)g(x) = g(x_1, \dots, x_n),其中每个变量 xix_i 本身是另一组变量 t1,…,tmt_1, \dots, t_m 的函数,即 xi=xi(t1,…,tm)x_i = x_i(t_1, \dots, t_m)。

    • 定义复合函数 h(t)=g(x(t))h(t) = g(x(t)),则其梯度满足:

      ∇h(t)=∇x(t)T ∇g(x(t)) \nabla h(t) = \nabla x(t)^T \, \nabla g(x(t))

      其中 ∇x(t)\nabla x(t) 是向量值函数 x(t)x(t) 的 Jacobian 矩阵(大小为 n×mn \times m),因此 ∇h(t)∈Rm\nabla h(t) \in \mathbb{R}^m。

    • 例如:若 f:Rn→Rf: \mathbb{R}^n \to \mathbb{R} 连续可微,定义 g(x)=f(Ax−b)g(x) = f(Ax - b),其中 A∈Rn×nA \in \mathbb{R}^{n \times n},b∈Rnb \in \mathbb{R}^n,则

      ∇g(x)=AT∇f(Ax−b) \nabla g(x) = A^T \nabla f(Ax - b)

  • 方向导数

    • 若 ff 连续可微,p∈Rnp \in \mathbb{R}^n,则 ff 在点 xx 沿方向 pp 的方向导数定义为:

      ∂f(x)∂p≡lim⁡ϵ→0f(x+ϵp)−f(x)ϵ=pT∇f(x) \frac{\partial f(x)}{\partial p} \equiv \lim_{\epsilon \to 0} \frac{f(x + \epsilon p) - f(x)}{\epsilon} = p^T \nabla f(x)

    • 为验证该公式,定义辅助函数:

      ϕ(α)=f(x+αp)=f(y(α)),其中 y(α)=x+αp \phi(\alpha) = f(x + \alpha p) = f(y(\alpha)), \quad \text{其中 } y(\alpha) = x + \alpha p

    • 注意到:

      lim⁡ϵ→0f(x+ϵp)−f(x)ϵ=lim⁡ϵ→0ϕ(ϵ)−ϕ(0)ϵ=ϕ′(0) \lim_{\epsilon \to 0} \frac{f(x + \epsilon p) - f(x)}{\epsilon} = \lim_{\epsilon \to 0} \frac{\phi(\epsilon) - \phi(0)}{\epsilon} = \phi'(0)

    • 由链式法则,

      ϕ′(α)=∑i=1n∂f(y(α))∂yi pi=pT∇f(y(α)) \phi'(\alpha) = \sum_{i=1}^n \frac{\partial f(y(\alpha))}{\partial y_i} \, p_i = p^T \nabla f(y(\alpha))

      因此 ϕ′(0)=pT∇f(x)\phi'(0) = p^T \nabla f(x),即方向导数等于梯度与方向向量的内积。

  • 泰勒级数

    • 泰勒级数(Taylor series)是一种在指定点 x0x_0 附近近似函数 ff 的工具,其近似结果是一个多项式。

    • 只要函数具有足够阶的导数,泰勒级数就可应用,常见用途包括:

      • 在 x0x_0 附近估计难以直接计算的函数值;
      • 利用近似多项式的导数或积分来估计原函数的导数或积分;
      • 推导求根、优化等数值算法。
    • 对一元函数 ff(具有 nn 阶连续导数),在点 x0x_0 处的 nn 阶泰勒展开为:

      f(x0+p)≈f(x0)+pf′(x0)+12!p2f′′(x0)+⋯+pnn!f(n)(x0) f(x_0 + p) \approx f(x_0) + p f'(x_0) + \frac{1}{2!} p^2 f''(x_0) + \cdots + \frac{p^n}{n!} f^{(n)}(x_0)

    • 前两项给出函数在 x0x_0 处的切线方程:

      y=f(x0)+(x−x0)f′(x0) y = f(x_0) + (x - x_0) f'(x_0)

    • 前三项给出二次近似。

    • 对多元函数 f:Rn→Rf: \mathbb{R}^n \to \mathbb{R},二阶泰勒展开为:

      f(x0+p)=f(x0)+pT∇f(x0)+12pT∇2f(x0)p+⋯ f(x_0 + p) = f(x_0) + p^T \nabla f(x_0) + \frac{1}{2} p^T \nabla^2 f(x_0) p + \cdots

    • 泰勒级数还有带余项的形式。若取前三项,则:

      • 一元情形:
        f(x0+p)=f(x0)+pf′(x0)+12p2f′′(ξ) f(x_0 + p) = f(x_0) + p f'(x_0) + \frac{1}{2} p^2 f''(\xi)
      • 多元情形:
        f(x0+p)=f(x0)+pT∇f(x0)+12pT∇2f(ξ)p f(x_0 + p) = f(x_0) + p^T \nabla f(x_0) + \frac{1}{2} p^T \nabla^2 f(\xi) p

        其中 ξ\xi 是介于 x0x_0 与 x0+px_0 + p 之间的某一点。
    • 通过分析余项的上界,可以评估近似的精度。更高阶项虽可写出,但符号复杂,本课程不作要求。

    • 练习:考虑函数

      f(x1,x2)=x13+5x12x2+7x1x22+2x23 f(x_1, x_2) = x_1^3 + 5x_1^2 x_2 + 7x_1 x_2^2 + 2x_2^3

      在点 x0=(−2, 3)Tx_0 = (-2,\, 3)^T 处,用二阶泰勒公式近似计算 f(−1.9, 3.2)f(-1.9,\, 3.2)。

      已知:

      f(x0)=−20,∇f(x0)=(15−10),∇2f(x0)=(1822228) f(x_0) = -20, \quad \nabla f(x_0) = \begin{pmatrix} 15 \\ -10 \end{pmatrix}, \quad \nabla^2 f(x_0) = \begin{pmatrix} 18 & 22 \\ 22 & 8 \end{pmatrix}

      令 p=(−1.9, 3.2)T−(−2, 3)T=(0.1, 0.2)Tp = (-1.9,\, 3.2)^T - (-2,\, 3)^T = (0.1,\, 0.2)^T,则二阶泰勒近似为:

      f(x0+p)≈f(x0)+pT∇f(x0)+12pT∇2f(x0)p f(x_0 + p) \approx f(x_0) + p^T \nabla f(x_0) + \frac{1}{2} p^T \nabla^2 f(x_0) p

      计算各项:

      • pT∇f(x0)=(0.1)(15)+(0.2)(−10)=1.5−2.0=−0.5p^T \nabla f(x_0) = (0.1)(15) + (0.2)(-10) = 1.5 - 2.0 = -0.5
      • $p^T \nabla^2 f(x_0) p =
        (0.1,, 0.2)
        \begin{pmatrix} 18 & 22 \ 22 & 8 \end{pmatrix}
        \begin{pmatrix} 0.1 \ 0.2 \end{pmatrix}
        = (0.1)(18\cdot0.1 + 22\cdot0.2) + (0.2)(22\cdot0.1 + 8\cdot0.2)
        = 0.62 + 0.76 = 1.38$

      因此:

      f(−1.9, 3.2)≈−20+(−0.5)+12(1.38)=−20−0.5+0.69=−19.81 f(-1.9,\, 3.2) \approx -20 + (-0.5) + \frac{1}{2}(1.38) = -20 - 0.5 + 0.69 = -19.81

凸集与凸函数

  • 仿射

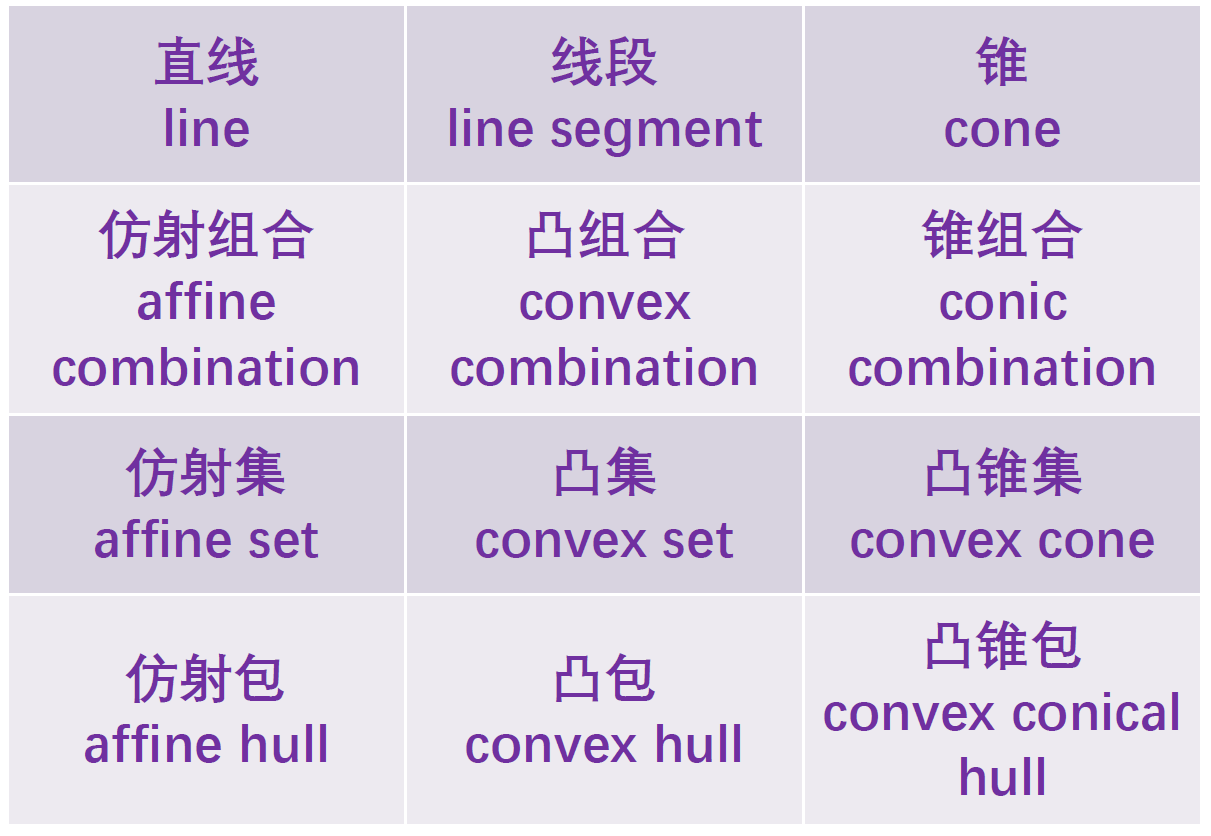
    • 一个集合 CC 称为仿射集(affine set),如果对任意 x,y∈Cx, y \in C 和任意实数 α∈R\alpha \in \mathbb{R},都有

      αx+(1−α)y∈C. \alpha x + (1 - \alpha) y \in C.

    • 当 xx 和 yy 是 Rn\mathbb{R}^n 中两个不同的点时,所有形如 z=αx+(1−α)yz = \alpha x + (1 - \alpha) y(α∈R\alpha \in \mathbb{R})的点构成通过 xx 和 yy 的直线。

    仿射直线
    • 由仿射集的定义可归纳得出:
      若 CC 是仿射集,x1,…,xk∈Cx_1, \dots, x_k \in C,且系数满足 α1+⋯+αk=1\alpha_1 + \cdots + \alpha_k = 1,则

      α1x1+⋯+αkxk∈C. \alpha_1 x_1 + \cdots + \alpha_k x_k \in C.

    • 换句话说,仿射集包含其任意点的仿射组合。

    • 仿射组合(Affine Combination)定义为:

      y=∑i=1kαixi,其中 ∑i=1kαi=1. y = \sum_{i=1}^{k} \alpha_i x_i, \quad \text{其中 } \sum_{i=1}^{k} \alpha_i = 1.

    • 例如,集合 {x∣Ax=b}\{x \mid Ax = b\}(线性方程组的解集)是一个仿射集。

    • 给定任意集合 CC,其所有仿射组合构成的集合称为 CC 的仿射包(affine hull),记作 aff⁡C\operatorname{aff} C,即

      aff⁡C={∑i=1kαixi | x1,…,xk∈C,  ∑i=1kαi=1,  k∈N}. \operatorname{aff} C = \left\{ \sum_{i=1}^{k} \alpha_i x_i \,\middle|\, x_1, \dots, x_k \in C,\; \sum_{i=1}^{k} \alpha_i = 1,\; k \in \mathbb{N} \right\}.

  • 凸

    • 一个集合 CC 称为凸集(convex set),如果对任意 x,y∈Cx, y \in C 和任意 α∈[0,1]\alpha \in [0, 1],都有

      αx+(1−α)y∈C. \alpha x + (1 - \alpha) y \in C.

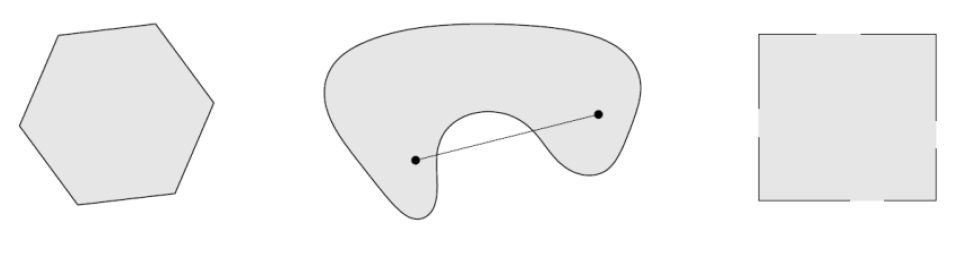
    • 换句话说,若 xx 和 yy 属于 CC,则连接 xx 与 yy 的线段也完全包含在 CC 中。

    凸集

    • 点 αx+(1−α)y\alpha x + (1 - \alpha) y(其中 α∈[0,1]\alpha \in [0,1])称为 xx 与 yy 的凸组合(convex combination)。

    • 凸组合的一般形式:

      y=∑i=1kαixi,其中 αi≥0,  ∑i=1kαi=1. y = \sum_{i=1}^{k} \alpha_i x_i, \quad \text{其中 } \alpha_i \geq 0,\; \sum_{i=1}^{k} \alpha_i = 1.

    • 一个集合是凸集,当且仅当它包含其任意点的所有凸组合。

    • 给定集合 CC,其所有凸组合构成的集合称为 CC 的凸包(convex hull),记作 conv⁡C\operatorname{conv} C,即

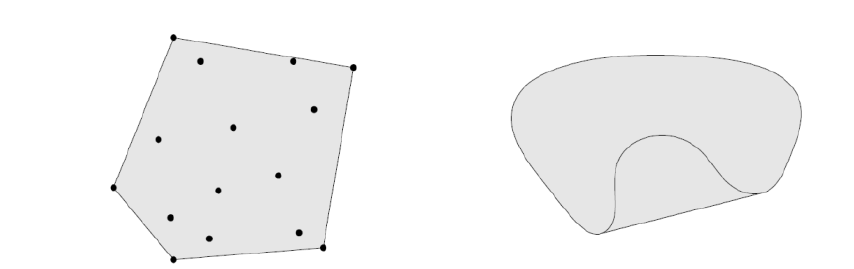
      conv⁡C={∑i=1kαixi | x1,…,xk∈C,  αi≥0,  ∑i=1kαi=1}. \operatorname{conv} C = \left\{ \sum_{i=1}^{k} \alpha_i x_i \,\middle|\, x_1, \dots, x_k \in C,\; \alpha_i \geq 0,\; \sum_{i=1}^{k} \alpha_i = 1 \right\}.

      凸包

    • 凸集的基本性质:

      • 若 C1C_1 和 C2C_2 是凸集,则以下集合也是凸集:
        • βC1\beta C_1(标量乘法,β∈R\beta \in \mathbb{R}),
        • C1+C2={x+y∣x∈C1,y∈C2}C_1 + C_2 = \{x + y \mid x \in C_1, y \in C_2\}(Minkowski 和),
        • C1−C2={x−y∣x∈C1,y∈C2}C_1 - C_2 = \{x - y \mid x \in C_1, y \in C_2\},
        • C1∩C2C_1 \cap C_2(交集,若非空)。
      • 按约定,空集 ∅\emptyset 被视为凸集。
  • 超平面和半空间

    • 超平面(Hyperplane)定义为:

      H={x∣aTx=b},a≠0 H = \{ x \mid a^T x = b \}, \quad a \neq 0

    • 半空间(Halfspace)分为两类:

      • 闭下半空间:$ H^+ = { x \mid a^T x \leq b } $
      • 闭上半空间:$ H^- = { x \mid a^T x \geq b } $

      其中 a≠0a \neq 0。

    • 超平面和半空间都是凸集。

      超平面和半空间

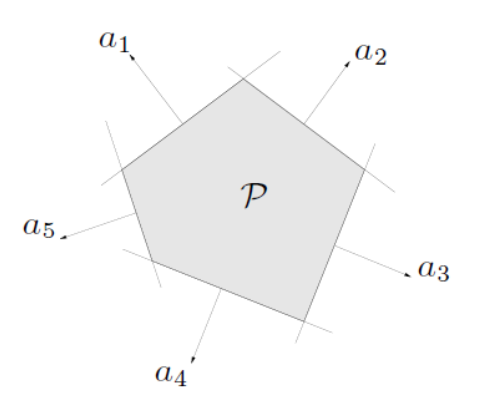
    • 多面体(Polyhedron)是指有限个半空间与超平面的交集。

      多面体
  • 范数球和范数锥

    • 范数球(Norm Ball):以 xcx_c 为中心、半径为 rr 的范数球定义为

      B(xc,r)={x∣∥x−xc∥≤r} B(x_c, r) = \{ x \mid \|x - x_c\| \leq r \}

      常见的范数球包括:

      • l1l_1-球:{x∣∥x−xc∥1≤r}\{ x \mid \|x - x_c\|_1 \leq r \}
      • l2l_2-球(欧几里得球):{x∣∥x−xc∥2≤r}\{ x \mid \|x - x_c\|_2 \leq r \}
      • l∞l_\infty-球:{x∣∥x−xc∥∞≤r}\{ x \mid \|x - x_c\|_\infty \leq r \}
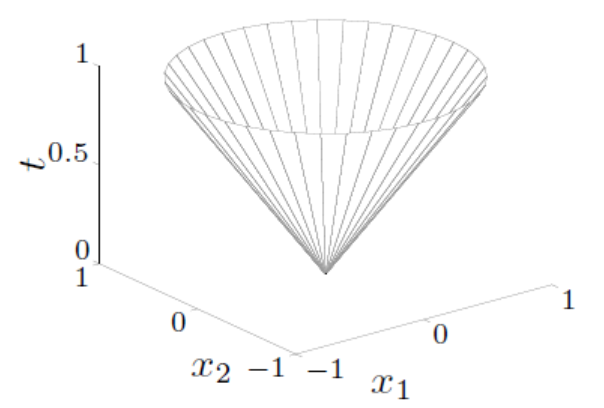
    • 范数锥(Norm Cone):

      {(x,t)∣∥x∥2≤t}⊆Rn+1 \{ (x, t) \mid \|x\|_2 \leq t \} \subseteq \mathbb{R}^{n+1}

      其中,欧几里得范数锥也称为二阶锥(Second-Order Cone)或冰激凌锥(Ice-Cream Cone)。

    二阶锥

    - 范数球和范数锥都是**凸集**。
  • 锥和锥组合

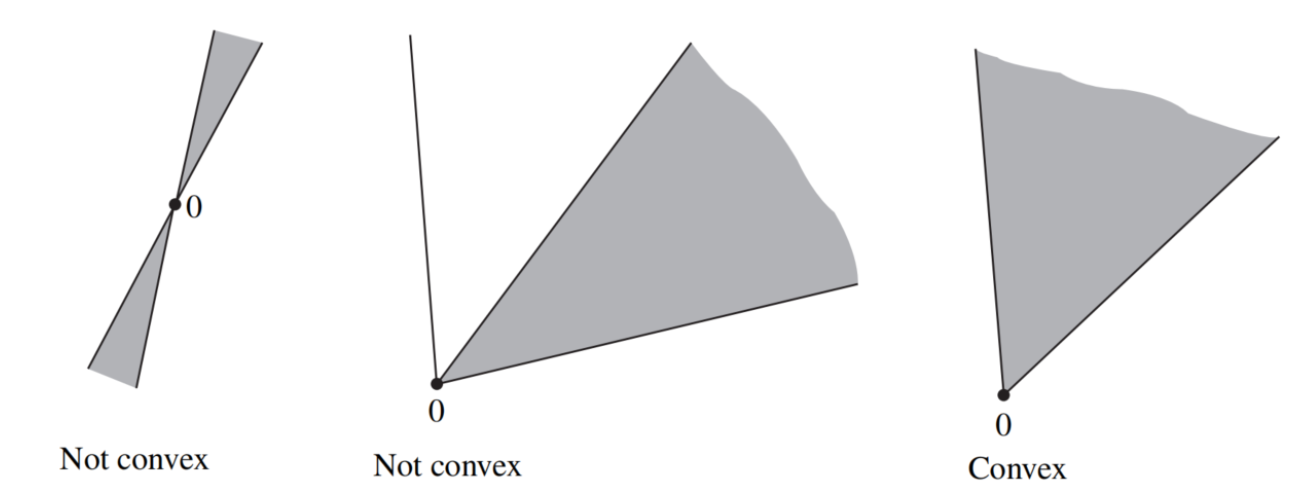
    • 一个集合 CC 称为锥(cone),如果对任意 x∈Cx \in C 和任意 θ≥0\theta \geq 0,都有

      θx∈C. \theta x \in C.

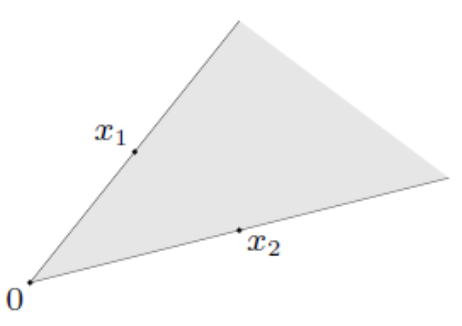
    • 锥组合(Conic Combination,或称非负组合)是指形如

      x=θ1x1+θ2x2 x = \theta_1 x_1 + \theta_2 x_2

      的线性组合,其中 θ1≥0\theta_1 \geq 0,θ2≥0\theta_2 \geq 0。(可推广到任意有限项)

    • 一个集合称为凸锥(convex cone),如果它包含其任意点的所有锥组合。

      凸锥

    • 等价地,集合 CC 是凸锥,当且仅当对任意 x,y∈Cx, y \in C 和任意 α,β≥0\alpha, \beta \geq 0,都有

      αx+βy∈C. \alpha x + \beta y \in C.

      凸锥1

    • 总结

    总结

  • 凸集分离
    设 D1,D2⊂RnD_1, D_2 \subset \mathbb{R}^n 为两个非空凸集。若存在非零向量 a∈Rna \in \mathbb{R}^n 和实数 β\beta,使得

    D1⊂H+={x∈Rn∣aTx≥β},D2⊂H−={x∈Rn∣aTx≤β}, D_1 \subset H^+ = \{ x \in \mathbb{R}^n \mid a^T x \geq \beta \}, \quad D_2 \subset H^- = \{ x \in \mathbb{R}^n \mid a^T x \leq \beta \},

    则称超平面
    H={x∈Rn∣aTx=β} H = \{ x \in \mathbb{R}^n \mid a^T x = \beta \}

    分离(separates)集合 D1D_1 和 D2D_2。

    进一步,如果

    D1⊂Ho+={x∈Rn∣aTx>β},D2⊂Ho−={x∈Rn∣aTx<β}, D_1 \subset H_o^+ = \{ x \in \mathbb{R}^n \mid a^T x > \beta \}, \quad D_2 \subset H_o^- = \{ x \in \mathbb{R}^n \mid a^T x < \beta \},

    则称超平面 HH 严格分离(strictly separates)D1D_1 和 D2D_2,其中 Ho+H_o^+ 和 Ho−H_o^- 分别表示 H+H^+ 和 H−H^- 的内部。

  • 投影定理
    设 D⊂RnD \subset \mathbb{R}^n 是一个非空闭凸集,点 y∈Rny \in \mathbb{R}^n 但 y∉Dy \notin D。

    1. 存在唯一最近点:
      存在唯一的点 xˉ∈D\bar{x} \in D,使得

      ∥xˉ−y∥=inf⁡x∈D∥x−y∥. \|\bar{x} - y\| = \inf_{x \in D} \|x - y\|.

    2. 最优性条件:
      xˉ∈D\bar{x} \in D 是 yy 到 DD 的最近点,当且仅当

      (x−xˉ)T(xˉ−y)≥0,∀x∈D. (x - \bar{x})^T (\bar{x} - y) \geq 0, \quad \forall x \in D.

    • 证明:

      (1) 存在唯一性

      • 距离函数 ∥x−y∥\|x - y\| 在闭集 DD 上连续,且 DD 非空 → 最小值可达(存在性)。
      • 因为 ∥x−y∥2\|x - y\|^2 是严格凸函数,而 DD 是凸集 → 最小值点唯一。

      (2) 最优性条件

      • 必要性:若 xˉ\bar{x} 是最近点,则对任意 x∈Dx \in D,线段上的点 zθ=xˉ+θ(x−xˉ)∈Dz_\theta = \bar{x} + \theta(x - \bar{x}) \in D(由凸性)。
        函数 θ↦∥zθ−y∥2\theta \mapsto \|z_\theta - y\|^2 在 θ=0\theta = 0 处最小,其导数 ≥0\geq 0,即

        ddθ∣θ=0∥zθ−y∥2=2(x−xˉ)T(xˉ−y)≥0. \frac{d}{d\theta}\Big|_{\theta=0} \|z_\theta - y\|^2 = 2(x - \bar{x})^T(\bar{x} - y) \geq 0.

      • 充分性:若 (x−xˉ)T(xˉ−y)≥0(x - \bar{x})^T(\bar{x} - y) \geq 0 对所有 x∈Dx \in D 成立,则

        ∥x−y∥2=∥xˉ−y∥2+2(x−xˉ)T(xˉ−y)+∥x−xˉ∥2≥∥xˉ−y∥2, \|x - y\|^2 = \|\bar{x} - y\|^2 + 2(x - \bar{x})^T(\bar{x} - y) + \|x - \bar{x}\|^2 \geq \|\bar{x} - y\|^2,

        所以 xˉ\bar{x} 确实是最接近 yy 的点。

  • 点与凸集分离定理
    设 D⊂RnD \subset \mathbb{R}^n 是一个非空闭凸集,点 y∈Rny \in \mathbb{R}^n 但 y∉Dy \notin D。则存 在非零向量 a∈Rna \in \mathbb{R}^n 和实数 β\beta,使得

    aTx≤β<aTy,∀x∈D. a^T x \leq \beta < a^T y, \quad \forall x \in D.

    这表示存在超平面
    H={x∈Rn∣aTx=β} H = \{ x \in \mathbb{R}^n \mid a^T x = \beta \}

    严格分离点 yy 与集合 DD:整个集合 DD 位于超平面的一侧(含边界),而点 yy 严格位于另一侧。

    • 证明:
      设 D⊂RnD \subset \mathbb{R}^n 是非空闭凸集,y∉Dy \notin D。
      由投影定理,存在唯一的 xˉ∈D\bar{x} \in D 使得 ∥xˉ−y∥\|\bar{x} - y\| 最小,且满足

      (x−xˉ)T(xˉ−y)≥0,∀x∈D. (x - \bar{x})^T(\bar{x} - y) \geq 0, \quad \forall x \in D.

      整理不等式得:

      xT(y−xˉ)≤xˉT(y−xˉ),∀x∈D. x^T(y - \bar{x}) \leq \bar{x}^T(y - \bar{x}), \quad \forall x \in D.

      令 a=y−xˉa = y - \bar{x}。因为 y≠xˉy \neq \bar{x},所以 a≠0a \neq 0。
      上式变为:

      aTx≤aTxˉ,∀x∈D. a^T x \leq a^T \bar{x}, \quad \forall x \in D.

      又因为 aTy=aT(xˉ+a)=aTxˉ+∥a∥2>aTxˉa^T y = a^T(\bar{x} + a) = a^T \bar{x} + \|a\|^2 > a^T \bar{x},
      所以对所有 x∈Dx \in D 有:

      aTx≤aTxˉ<aTy. a^T x \leq a^T \bar{x} < a^T y.

      令 β=aTxˉ\beta = a^T \bar{x},则

      aTx≤β<aTy,∀x∈D, a^T x \leq \beta < a^T y, \quad \forall x \in D,

      即超平面 {x∣aTx=β}\{x \mid a^T x = \beta\} 严格分离点 yy 与集合 DD。

  • 支撑超平面

    • 设 D⊂RnD \subset \mathbb{R}^n 是非空集合,点 xˉ∈∂D\bar{x} \in \partial D(即 xˉ\bar{x} 是 DD 的边界点)。
      若存在非零向量 a∈Rna \in \mathbb{R}^n,使得

      D⊂Hxˉ+={x∈Rn∣aT(x−xˉ)≥0} D \subset H_{\bar{x}}^+ = \{ x \in \mathbb{R}^n \mid a^T(x - \bar{x}) \geq 0 \}

      或
      D⊂Hxˉ−={x∈Rn∣aT(x−xˉ)≤0}, D \subset H_{\bar{x}}^- = \{ x \in \mathbb{R}^n \mid a^T(x - \bar{x}) \leq 0 \},

      则称超平面
      Hxˉ={x∈Rn∣aT(x−xˉ)=0} H_{\bar{x}} = \{ x \in \mathbb{R}^n \mid a^T(x - \bar{x}) = 0 \}

      为集合 DD 在点 xˉ\bar{x} 处的一个支撑超平面。

    • 若 DD 是非空凸集,则在其每一个边界点处都存在至少一个支撑超平面。

  • 两个凸集的分离定理

    • 设 D1,D2⊂RnD_1, D_2 \subset \mathbb{R}^n 为两个非空凸集,且 D1∩D2=∅D_1 \cap D_2 = \emptyset。
      则存在一个超平面分离 D1D_1 与 D2D_2,即存在非零向量 a∈Rna \in \mathbb{R}^n,使得

      aTx≤aTy,∀ x∈D‾1,  y∈D‾2. a^T x \leq a^T y, \quad \forall\, x \in \overline{D}_1,\; y \in \overline{D}_2.

    • 证明:
      令 D=D1−D2={x−y∣x∈D1,  y∈D2}D = D_1 - D_2 = \{ x - y \mid x \in D_1,\; y \in D_2 \}。
      由于 D1D_1 和 D2D_2 均为凸集,其差集 DD 也是凸集;又因 D1∩D2=∅D_1 \cap D_2 = \emptyset,故 0∉D0 \notin D。

      考虑闭包 D‾\overline{D},它仍是凸集且不包含原点。由点与闭凸集的分离定理,存在非零向量 a∈Rna \in \mathbb{R}^n,使得

      aTz≤0,∀ z∈D‾. a^T z \leq 0, \quad \forall\, z \in \overline{D}.

      对任意 x∈D‾1x \in \overline{D}_1、y∈D‾2y \in \overline{D}_2,有 z=x−y∈D‾z = x - y \in \overline{D},代入得

      aT(x−y)≤0  ⟹  aTx≤aTy, a^T (x - y) \leq 0 \;\Longrightarrow\; a^T x \leq a^T y,

      即所求分离不等式成立。

  • Farkas 引理
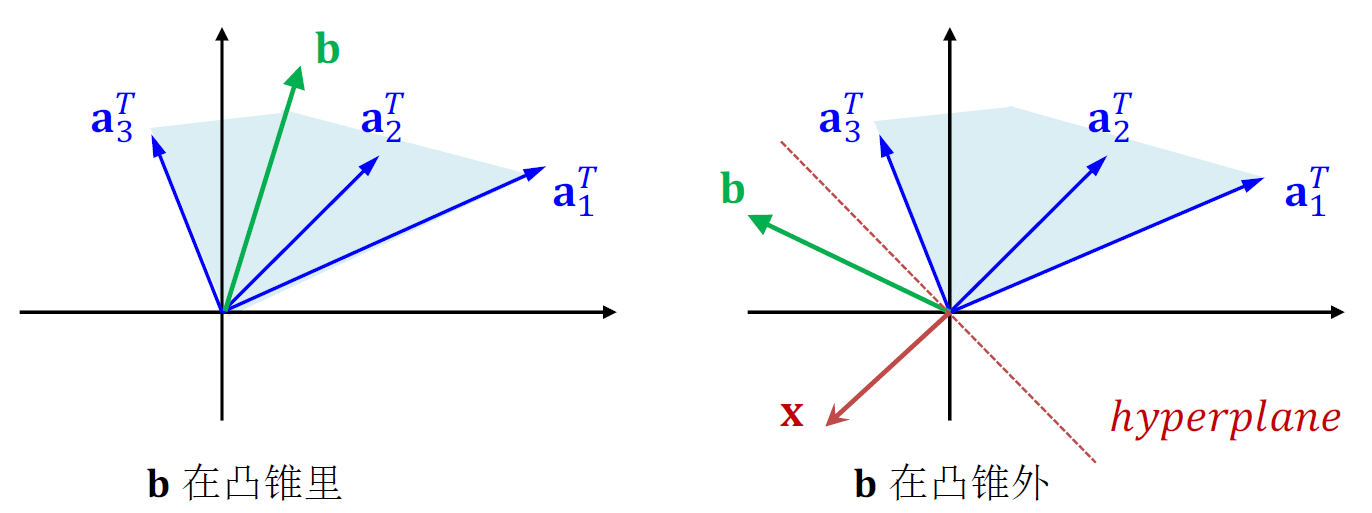
    设 A∈Rm×nA \in \mathbb{R}^{m \times n},b∈Rnb \in \mathbb{R}^n。则以下两个系统中有且仅有一个有解:

    • 系统 (1):

      ATy=b,y≥0 A^T y = b, \quad y \geq 0

    • 系统 (2):

      Ax≤0,bTx>0 Ax \leq 0, \quad b^T x > 0

      其中 x∈Rnx \in \mathbb{R}^n,y∈Rmy \in \mathbb{R}^m。

    • 几何理解:

    Farkas

  • 凸函数

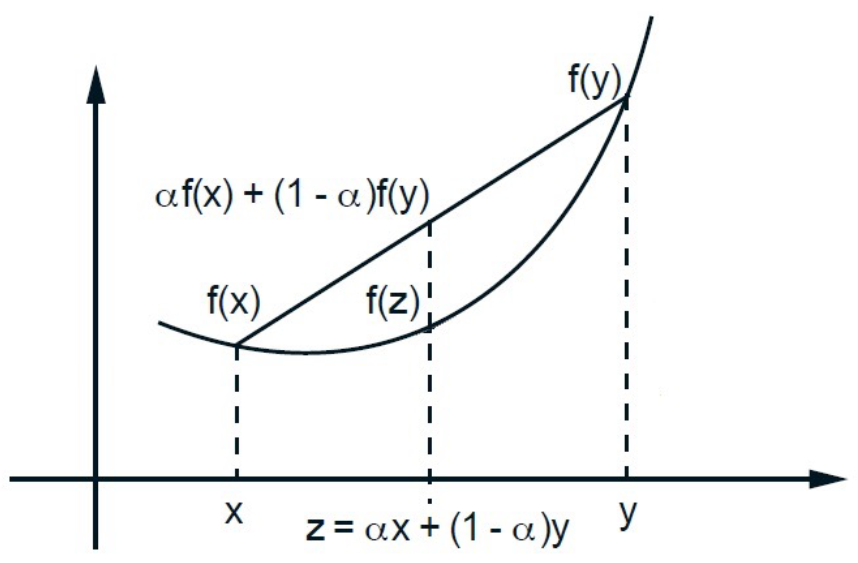
    • 设 C⊂RnC \subset \mathbb{R}^n 为凸集,函数 f:C→Rf: C \to \mathbb{R} 称为 凸函数,如果对任意 x,y∈Cx, y \in C 和任意 α∈(0,1)\alpha \in (0,1),都有

      f(αx+(1−α)y)≤αf(x)+(1−α)f(y). f(\alpha x + (1 - \alpha) y) \leq \alpha f(x) + (1 - \alpha) f(y).

    • 若上述不等式对所有 x≠y∈Cx \neq y \in C 和 α∈(0,1)\alpha \in (0,1) 严格成立,即

      f(αx+(1−α)y)<αf(x)+(1−α)f(y), f(\alpha x + (1 - \alpha) y) < \alpha f(x) + (1 - \alpha) f(y),

      则称 ff 为 严格凸函数。

    • 凸函数(或严格凸函数)的相反数称为 凹函数(或严格凹函数)。

    • 线性函数既是凸函数,也是凹函数。

    凸函数

    • 一阶条件(适用于定义在凸集 CC 上的可微函数 ff):
      • 函数 ff 在 CC 上是凸函数,当且仅当

        f(y)≥f(x)+∇f(x)T(y−x),∀ x,y∈C. f(y) \geq f(x) + \nabla f(x)^T (y - x), \quad \forall\, x, y \in C.

      • 函数 ff 在 CC 上是严格凸函数,当且仅当

        f(y)>f(x)+∇f(x)T(y−x),∀ x,y∈C,  x≠y. f(y) > f(x) + \nabla f(x)^T (y - x), \quad \forall\, x, y \in C,\; x \neq y.

        凸函数的一阶条件

    该条件表明:凸函数在其任意点处的一阶泰勒展开是全局下界;严格凸时,该下界在其他点严格成立。

    • 二阶条件(适用于定义在开凸集 C⊂RnC \subset \mathbb{R}^n 上的二阶连续可微函数 ff):

      • 函数 ff 在 CC 上是凸函数,当且仅当其 Hessian 矩阵半正定,即

        ∇2f(x)⪰0,∀ x∈C. \nabla^2 f(x) \succeq 0, \quad \forall\, x \in C.

      • 若对所有 x∈Cx \in C,Hessian 矩阵正定,即

        ∇2f(x)≻0, \nabla^2 f(x) \succ 0,

        则 ff 是严格凸函数。
        (注:这是严格凸的充分条件,但非必要条件。)

    • 一维凸函数的例子:

      • 指数函数:f(x)=eaxf(x) = e^{a x},其中 a∈Ra \in \mathbb{R},在 R\mathbb{R} 上是凸函数。

      • 幂函数:f(x)=xαf(x) = x^{\alpha},定义在 x>0x > 0 上,当 α≥1\alpha \geq 1 或 α≤0\alpha \leq 0 时为凸函数。

      • 负对数函数:f(x)=−ln⁡xf(x) = -\ln x,在 x>0x > 0 上是凸函数。

      • 负熵函数:f(x)=xln⁡xf(x) = x \ln x,在 x>0x > 0 上是凸函数(约定 0ln⁡0=00 \ln 0 = 0 可将其连续延拓至 x=0x = 0)。

      • 需要注意的是,并非所有凸函数都是可微的。

        • 一个简单的不可微凸函数例子是绝对值函数:
          f(x)=∣x∣={x,若 x≥0,−x,若 x<0. f(x) = |x| = \begin{cases} x, & \text{若 } x \geq 0, \\ -x, & \text{若 } x < 0. \end{cases}

          该函数在 x=0x = 0 处不可导,但在整个 R\mathbb{R} 上是凸函数。
    • 上方图

      • 设 ff 是定义在集合 S⊂RnS \subset \mathbb{R}^n 上的实值函数。
        函数 ff 的上镜图(epigraph)定义为

        epi⁡f={(x,μ)∈Rn+1 | x∈S,  μ≥f(x)}. \operatorname{epi} f = \left\{ (x, \mu) \in \mathbb{R}^{n+1} \,\middle|\, x \in S,\; \mu \geq f(x) \right\}.

        它表示 Rn+1\mathbb{R}^{n+1} 中位于函数图像之上或恰好在图像上的所有点构成的集合。

      • 设 S⊂RnS \subset \mathbb{R}^n 是非空凸集,则函数 f:S→Rf: S \to \mathbb{R} 是凸函数 当且仅当 其上镜图 epi⁡f\operatorname{epi} f 是 Rn+1\mathbb{R}^{n+1} 中的凸集。

      这一定理建立了凸函数与凸集之间的等价关系,常用于证明某些函数的凸性。

    • 水平集 (Level Set)
      假设 ff 是定义在 L⊂RnL \subset \mathbb{R}^n 上的实值函数。对于任意 α∈R\alpha \in \mathbb{R},集合

      Lα={x∣f(x)≤α,  x∈L} L_\alpha = \{ x \mid f(x) \leq \alpha, \; x \in L \}

      称为函数 ff 的 α\alpha 水平集。

      若 L⊂RnL \subset \mathbb{R}^n 是非空凸集,且 ff 是定义在 LL 上的凸函数,则对任意 α∈R\alpha \in \mathbb{R},水平集 LαL_\alpha 是一个凸集。

      • 水平集是所有满足 f(x)≤αf(x) \leq \alpha 的点 xx 构成的集合。
      • 如果函数 ff 是凸函数,并且其定义域是凸集,则该函数的所有水平集也是凸集。这为我们判断某些集合是否为凸提供了一种方法。
  • 凸规划

    • 凸规划(Convex Programming)是指如下形式的优化问题:

      min⁡x∈Sf(x) \min_{x \in S} f(x)

      其中,可行域 S⊂RnS \subset \mathbb{R}^n 是一个凸集,目标函数 ff 在 SS 上是凸函数。

    • 示例:
      考虑问题

      min⁡f(x)s.t.gi(x)≥0,i=1,…,m \begin{aligned} \min \quad & f(x) \\ \text{s.t.} \quad & g_i(x) \geq 0, \quad i = 1, \dots, m \end{aligned}

      若目标函数 f(x)f(x) 是凸函数,且每个约束函数 gi(x)g_i(x) 是凹函数,则该问题是凸规划。

    • 理由:
      由于 gig_i 是凹函数,集合 {x∣gi(x)≥0}\{x \mid g_i(x) \geq 0\} 是凸集(凹函数的上水平集为凸集)。
      多个凸集的交集仍是凸集,因此可行域

      S=⋂i=1m{x∣gi(x)≥0} S = \bigcap_{i=1}^m \{x \mid g_i(x) \geq 0\}

      是凸集。结合 ff 为凸函数,该问题满足凸规划的定义。

  • 可行性

    • 考虑如下形式的约束条件:

      gi(x)=0,i∈E(等式约束)gi(x)≥0,i∈I(不等式约束) \begin{aligned} g_i(x) &= 0, && i \in E \quad \text{(等式约束)} \\ g_i(x) &\geq 0, && i \in I \quad \text{(不等式约束)} \end{aligned}

    • 满足所有约束条件的点称为可行点(feasible point)。
      所有可行点构成的集合称为可行域(feasible region)或可行集。

    • 在一个可行点 xˉ\bar{x} 处,不等式约束 gi(x)≥0g_i(x) \geq 0 被称为:

      • 起作用(active / binding),如果 gi(xˉ)=0g_i(\bar{x}) = 0(即该点位于约束边界上);
      • 不起作用(inactive / nonbinding),如果 gi(xˉ)>0g_i(\bar{x}) > 0(即该点位于约束内部)。
    • 所有等式约束在任意可行点处均视为起作用。

    • 在可行点 xˉ\bar{x} 处的起作用集(active set)定义为在该点处所有起作用约束(包括全部等式约束和满足 gi(xˉ)=0g_i(\bar{x}) = 0 的不等式约束)的下标集合。

    • 所有满足至少一个不等式约束起作用(即 gi(x)=0g_i(x) = 0 对某个 i∈Ii \in I 成立)的可行点,构成可行域的边界。

    • 其余的可行点(即所有不等式约束均严格成立:gi(x)>0g_i(x) > 0 对所有 i∈Ii \in I)称为可行域的内点。

    • 对于无约束优化问题,可行集 SS 即为整个 Rn\mathbb{R}^n。

  • 最优性

    • 若点 x∗x^* 满足

      f(x∗)≤f(x),∀ x∈S, f(x^*) \leq f(x), \quad \forall\, x \in S,

      则称 x∗x^* 为函数 ff 在集合 SS 上的全局最小值点(global minimizer)。

    • 若进一步满足

      f(x∗)<f(x),∀ x∈S 且 x≠x∗, f(x^*) < f(x), \quad \forall\, x \in S \text{ 且 } x \neq x^*,

      则称 x∗x^* 为 ff 在 SS 上的严格全局最小值点(strict global minimizer)。